这本书的作者有点反差。
项舒杨,巴黎皮埃尔和居里大学(现在并入索邦大学)数学博士,做的方向是相对论与黑洞。后来去法国路桥大学和亚琛工大做博士后,在亚琛当过讲师,现在是一线的数据科学家,同时管着巴黎规模最大的机器学习社团。
在豆瓣上,她的名字叫 Charlotte,写数学科普,文风很软。她在一期播客里说过一段话:数学不是计算器能代劳的算术,是一种看世界的方式,能帮人抵御偏见、识破谎言。
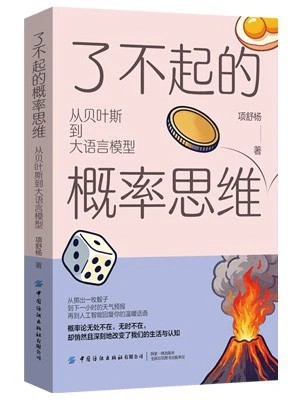
《了不起的概率思维》就是这句话的展开。副标题"从贝叶斯到大语言模型",听起来像两件不相干的事被硬凑在一起,其实是同一条线索的两端。
一、这本书的结构,比它的内容更值得说
二十一章,看着像一本正经的教材,目录却是这样排的:
不确定的世界 → 信念更新 → 数据的表达 → 从偶然到必然 → 给机器任务 → 偏微分方程 → 难下的山 → 最简单的世界 → 复杂边界 → 从前因到后果 → 爬上因果阶梯 → 从静态到动态 → 预测未来 → 语言这件大事 → 两则题外话 → 神经网络 → 深度学习 → 马尔可夫链 → 从依赖性到可计算性 → 大语言模型 → 能和人工智能做朋友吗
粗略地说,前五章是把人放回"不确定"里,讲人怎么判断;第十六章往后才是机器:神经网络、深度学习、马尔可夫链、大语言模型。
中间夹着第六章"偏微分方程"。这一章最容易让人卡住——一本讲概率的通识书,为什么突然讲偏微分方程?
我的理解是,它在补一块地基。偏微分方程描述的是"变化如何传播":热在金属棒里怎么传导、浓度怎么从高到低渗透、波怎么扩散开。物理学用它处理连续世界。而概率论走到随机过程这一支,描述的也是另一种"扩散"——随机性、噪声、不确定性如何在系统里一层层蔓延。两套语言在数学结构上是通的。
这一章的位置也说明作者的用心:她想让读者在进入机器之前,先习惯"过程"这个视角,而不只是"事件"。前面讲的是某一次判断准不准,后面讲的是连续演化的系统。
这个安排不是炫技。它对应了一个真实的历史:概率论从赌桌和保险业起家,一路走到今天成了机器智能的底层语言。作者没有把这个过程写成编年史,而是让读者先在人的尺度上把概念摸熟,再被推到机器的尺度上。这个"由人到机器"的顺序,是这本书最讲究的地方。
二、它讲的其实是一件很朴素的事:判断可以被修正
书里最实用的一章是第二章"信念更新",讲贝叶斯。
贝叶斯公式在所有概率教材里都是重点,但也最容易讲成公式推导。这本书的处理是把它还原成一个动作:你先有一个判断,然后拿到新证据,把判断调一调。这个动作可以反复做,做一次叫修正,做一百次就叫学习。
作者在播客里提过一个经典问题,最早是统计学家用来解释"混杂变量"的:为什么在体重不足的新生儿里,母亲抽烟的那一组存活率反而更高?直觉会立刻给出一个荒谬的结论——抽烟对早产儿有好处。但把人群按出生体重再细分一层,这个结论就塌了:在同一个体重区间内,不抽烟的母亲生下的孩子存活率更高;抽烟组整体存活率高,只是因为这一组里原本就少了一批极轻的婴儿——那批最脆弱的,很多没能活着进入统计。
换句话说,抽烟的伤害是真实的,只是被体重这个变量掩盖了。分开看和合起来看,结论完全相反。这个现象后来被叫作辛普森悖论,逻辑不难,但要人真的转过来,得靠训练。作者的看法是:人天生不是用贝叶斯思考的动物,但这点计算量并不大,练一练就能避开日常里大量的偏见。
书里还提到一个更日常的场景。长辈说"什么年龄就该做什么事",这话听着没法反驳,因为它是用"应该"包装的。但如果把它翻译成概率语言,问题就变了:在这个年龄做这件事的成功率是多少?不做的代价是什么?"该做"这件事的样本是谁——是我的同龄人,还是三十年前的同龄人?这些问句一出来,"应该"就散了。
这就是作者说的"抵御偏见、识破谎言"——不是靠更聪明的头脑,是靠一套能把模糊判断拆成可检验部分的习惯。
还有个例子能说明概率有多反直觉。假设一种病的患病率是千分之一,检测的准确率是 99%(有病测出阳性、没病测出阴性的概率都是 99%)。一个人测出阳性,他真的有病的概率是多少?大多数人的直觉是 99%。实际算下来只有 9% 左右。因为在一千个人里,真正有病的只有 1 个,而 999 个健康人里会有大约 10 个被误判为阳性。阳性结果里,误报比真病例还多。
贝叶斯公式做的就是这件事:它强迫你把"基础概率"放回计算里。人脑不擅长这个,直觉会自动忽略分母,只盯着那个 99%。
三、后半本:机器是怎么"理解"语言的
从第十六章开始,书进入技术部分:神经网络、深度学习、马尔可夫链、大语言模型。
这部分最容易写成术语的堆砌。作者的处理仍然是"降回生活":马尔可夫链说白了就是"根据现在猜下一步,不需要记得全部过去";神经网络是一层层加权求和再决定要不要激活;大语言模型做的事,本质上是给定前文,算下一个词的概率分布,然后采样。
这个描述听起来简陋,但它戳中了一个关键:大模型不是在"理解",它是在做极高维度的概率预测。它输出的不确定性不是故障,是这套机制的固有属性。所以幻觉、前后不一致、同一个问题两次回答不同,都不是 bug,是原理决定的。
明白了这一点,使用大模型的心态就会变。不会把它当一台永远正确的问答机,而会把它当一个需要被约束、被验证、被反复核对的概率引擎。作者在播客里说了一句很实在的话:总是顺着你的 AI 很危险,你需要一点对抗。这句话和书里最后一章"能和人工智能做朋友吗"是同一个意思——不是敌意,是保持判断力。
四、它不完美的地方
得说实话,这本书有它够不着的地方。
第一,它不深。作为通识读物,它把每个概念都停在"能理解"的层面,不推到"能计算"的层面。想真正学会贝叶斯推断、想自己动手跑一个神经网络,这本书不够用。它给的是地图,不是工具。
第二,二十一章、248 页、14 万字,平均每章不到七千字。这个密度对通识书是合适的,但有些章节(比如"两则题外话")更像随笔,和主线的关系松。作者大概也知道,取名就叫"题外话"。
第三,前后两半的读者不完全是一批人。前半本写给想改善判断力的普通人,后半本写给想搞懂 AI 的人。两边都想要的读者会觉得顺畅,只想要一边的,会觉得另一半是负担。
这些不算硬伤,是体裁的代价。
还有一点得提醒:书里的示意图不少,用意是用图替代公式。这是好意,但图能表达的东西有上限。贝叶斯公式的三层结构(先验、似然、后验)用一张图能看懂意思,可一旦要算具体数值,还是得回到式子。所以这本书的定位最好是"带你看懂",不是"教你算"。
另外,它写到大语言模型为止,没怎么碰多模态、推理模型这些更近的东西。书里说"概率是机器理解语言的核心机制",这个判断在 2026 年依然成立,但边界正在移动。读的时候心里有个数就好。
五、值得说一句的出版信息
中国纺织出版社,2026 年 8 月,平装,定价 59.80 元。8 月上架,豆瓣评分 8.8,评价人数还不多——这个分数参考价值有限,但至少说明先读的那批人没有失望。
顺便说一句,中国纺织出版社出这样一本讲贝叶斯和大模型的书,本身有点出人意料。这家社的传统强项是纺织、服装、轻工,近几年在科普上铺得比较开。2026 年 9 月的《科普时报》成人科普书榜把它列了进去,和尹烨的《生命密码》系列、商务的《粪便简史》放在一起——这个组合本身就说明,它被当成一本大众读物,而不是一本专业教材。
书做得规整,32 开,纸不薄,排版留白多,读起来不挤。
最后
这本书让我想起作者自己的一个经历。她在播客里说,本科原本想学草坪管理,后来转到数学,再后来搞 AI。她说不是每个人都适合学数学专业,数学也不是天才才能做的事,它可以很日常。
这句话和这本书的写法是一致的。它没有摆出"读完就懂 AI"的架势,也没有把概率讲成一门要应付的考试。它做的事更朴素:把"不确定"这件事拆开,让你看见人在其中怎么判断,机器又怎么在其中"判断",然后告诉你,这两件事的底层是同一套东西。
读完不一定能算得更准,但至少会多问一句:这个结论,是在什么前提下成立的?样本是谁?我看到的,是不是已经被筛过一遍的世界?
在这个到处都是"精准预测"和"绝对判断"的年代,这种迟疑,比自信值钱。
本文来自作者欣文学原创投稿,不代表欣文网任何立场,投稿原创内容是作者的心血请尊重其版权,如有侵权必追究其法律责任。如需转载请与原作者联系,转载并注明出处:https://www.xinenw.com/56903.html